FLUX 3black forest labsによる
画像、動画、音声、行動予測に対応する、ひとつのマルチモーダルモデル。
あらゆるスタイルで、よりリアルな表現を。
AdobeMicrosoftPicsartGrinOpenAI
ひとつのモデルで、
複数のモダリティに対応。
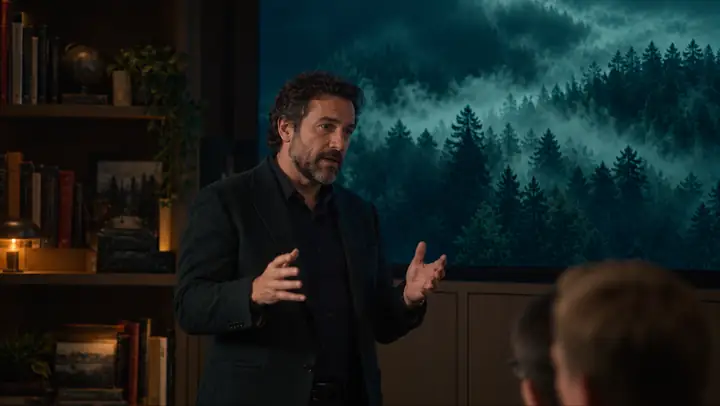
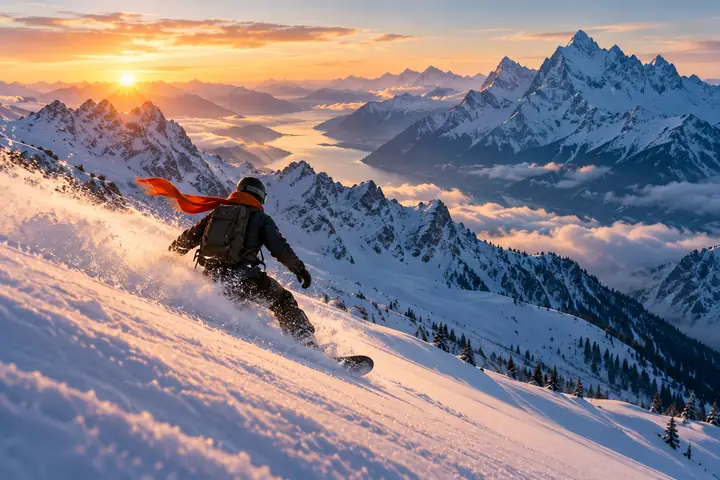
シネマティックな表現にとどまらない、多彩なスタイル。音声にもネイティブに対応し、一度の生成でクリップを作れます。テキスト、画像、キーフレームから始めて、ワンテイクで複数のショットを試せます。
音もシーンの一部に。会話、効果音、環境音が映像に新たな奥行きをもたらします。
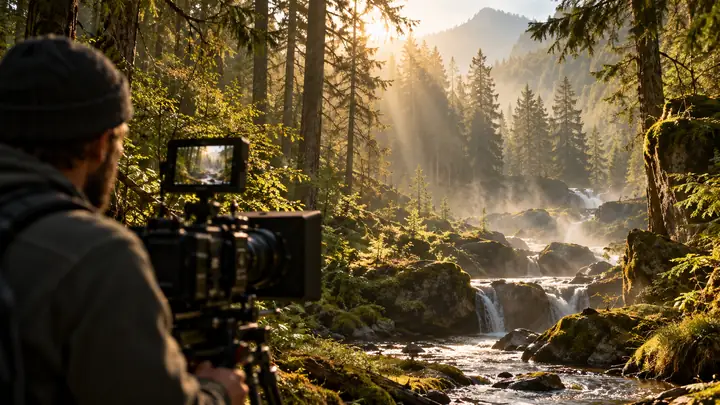
現実世界に根ざした画像を、多彩なスタイルと細部まで指定したプロンプトで生成。
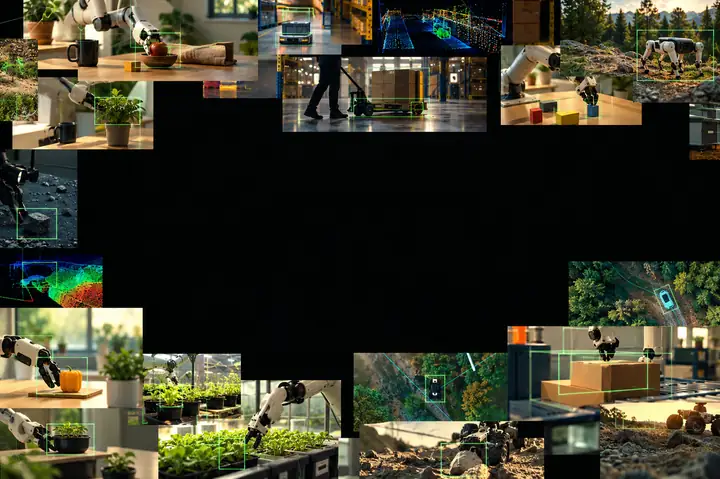
視覚的な観察と指示によって、モデルが見たものを次に起こることへとつなげられます。
1 / 9
FLUX 3のご紹介
画像のための1つのモデル
すぐに使えます。
APIを通じたスケールアップも、自社インフラでの公開ウェイトの実行も、気軽な実験も。私たちのモデルは、あなたの作業環境で使えます。
プレイグラウンドで試し、APIで統合。モデルをダウンロードしてカスタマイズし、どこにでもデプロイできます。